Bayesian BM25
BM25 die weet wat het niet weet.
BM25 is een point-estimate ranking-functie: het leest document-frequentie, gemiddelde lengte en twee tuning-constanten van het corpus en behandelt ze als feit. Op zeldzame termen, korte velden en kleine of koude collecties zijn die schattingen ruisig, en wordt de ranking instabiel. Bayesian BM25 zet priors op die statistiek, trekt dun bewijs naar het corpus en leert zijn parameters mét onzekerheid in plaats van één globale gok.
Wat de prior u oplevert
Waarom een Bayesiaanse aanpak een getunede constante verslaat.
Gekalibreerd op zeldzame termen
Klassieke BM25 leidt zijn IDF af uit een point-estimate van de document-frequentie. Op long-tail termen (die in een handvol documenten voorkomen) is die schatting ruisig en kan één zeldzaam woord de ranking domineren. Een prior trekt schaarse statistiek naar het corpus, zodat zeldzame termen verstandig scoren in plaats van de resultatenset te laten omslaan.
Stabiel op kleine & koude corpora
Een verse index, een nieuwe tenant of een smal veld heeft te weinig data voor betrouwbare gemiddelden. Bayesiaanse smoothing leent kracht uit corpus-priors tot er genoeg bewijs is, zodat de zoekkwaliteit niet instort op dag één en convergeert naarmate de collectie groeit.
Parameters met onzekerheid
De k1- en b-knoppen zijn niet langer twee handmatig getunede globale constanten. Ze worden geschat met credible intervals, dus het model weet wanneer het te weinig data heeft om zeker te zijn, en valt terug op de prior in plaats van te overfitten op een dunne steekproef.
Per veld, per tenant
Titel-, body- en metadata-velden hebben sterk verschillende lengte- en frequentieverdelingen. Elk krijgt zijn eigen posterior in plaats van één compromis-instelling over de hele index, en het corpus van elke tenant tunet zichzelf.
Soepel met lengte
De lengtenormalisatie past zich aan de werkelijke lengteverdeling van het veld aan, in plaats van elk kort en lang document tegen één globaal gemiddelde te meten, zodat samenvattingen en volledige rapporten op hun eigen merites scoren.
Past in hybride retrieval
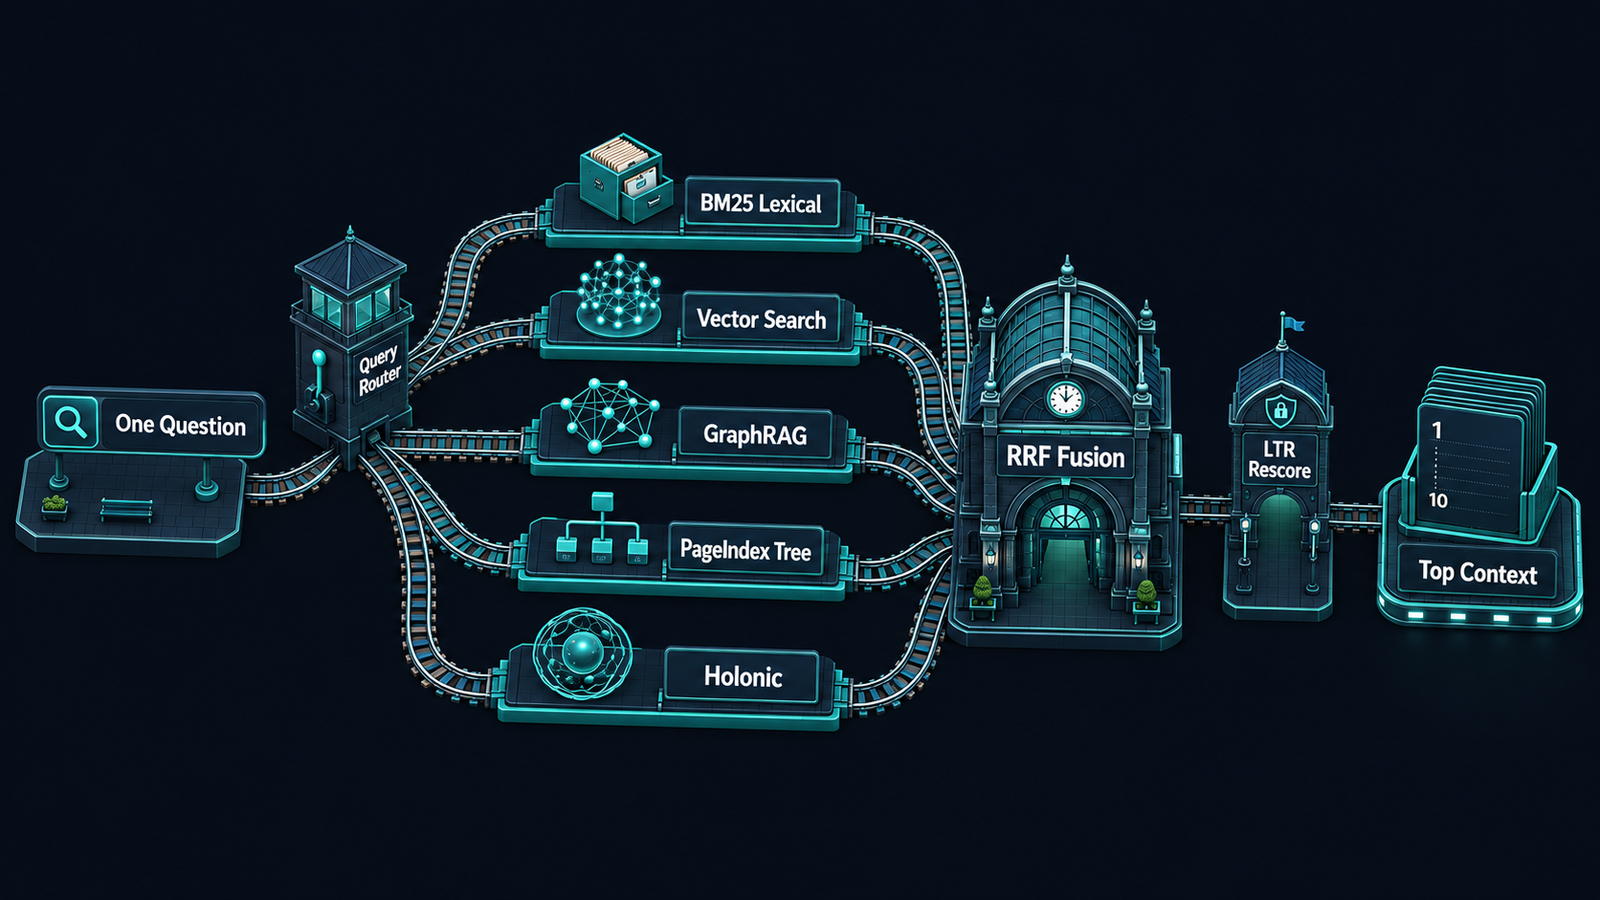
Het blijft BM25: dezelfde inverted index, gefuseerd via RRF met dense-vector- en graph-context-signalen. De Bayesiaanse laag verandert hóe de lexicale scores worden geschat, niet de retrieval-architectuur eromheen.
Onderdeel van hybride retrieval
Lexicale precisie, gekalibreerd.
Dense vectoren vinden wat u bedoelt; lexicale search vindt wat u zei. Bayesian BM25 houdt de lexicale helft eerlijk, stabiel op de zeldzame, exacte termen die er het meest toe doen in juridische, overheids- en technische corpora, voordat RRF het fuseert met vector- en graph-signalen tot één gerangschikt, citation-backed resultaat.